Airflow Workflow Control ( Decisions & Dependencies )
Task Dependencies
Key Parameters
task1 >> task2: Upstream Series ( task1 runs Before task2 )task1 << task2: Downstream Series ( task1 runs After task2 )[ task1 , task2 ]: Parallel (AND dependency)
📌 Use case: Build flexible workflows
Trigger Rules > OR - AND Logic
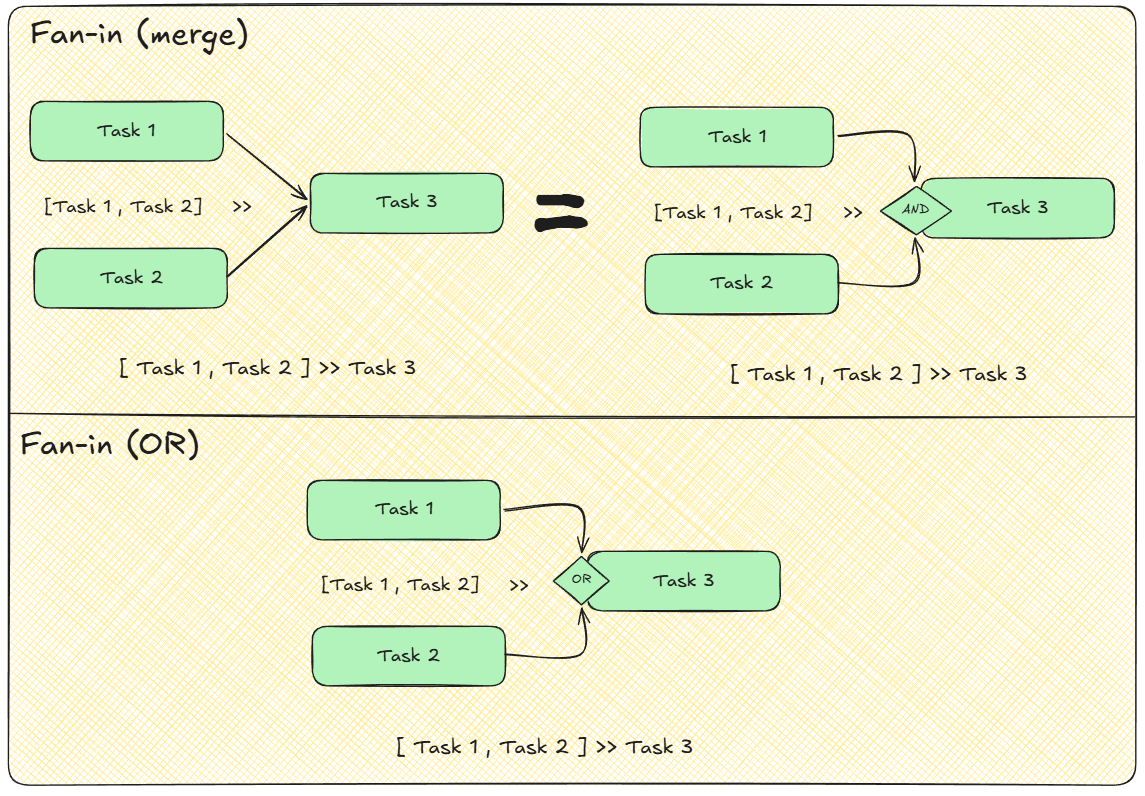
trigger_rule='all_success': AND (task runs only if all upstream tasks succeed)trigger_rule='one_success': OR (task runs if at least one upstream task succeeds)trigger_rule='all_failed': All Fail (runs only if all upstream tasks fail)trigger_rule='one_failed': Any Fail (runs if at least one upstream task fails)trigger_rule='none_failed': No Failures (runs if no upstream task failed)
📌 Use case: Control task execution based on upstream results (AND / OR / failure logic)
# ===================== Import Libraries =====================
from airflow import DAG
from airflow.operators.bash import BashOperator
from airflow.operators.empty import EmptyOperator
from datetime import datetime

# ===================== Default Arguments =====================
default_args = {
    'owner': 'airflow',
    'start_date': datetime(2026, 4, 20),
}

# ===================== DAG Definition =====================
with DAG(
    dag_id='trigger_rule_demo',
    default_args=default_args,
    schedule_interval=None,
    catchup=False
) as dag:

    # ===================== Source Task A =====================
    source_a = BashOperator(
        task_id='source_a',
        bash_command='echo "A done"'
    )

    # ===================== Source Task B  =====================
    source_b = BashOperator(
        task_id='source_b',
        bash_command='exit 1'  # intentionally fails
    )

    # ===================== Merge Task with Trigger Rule =====================
    merge_task = EmptyOperator(
        task_id='merge_task',
        trigger_rule='all_success'  # one_success
    )

    # ===================== Task Dependencies =====================
    [source_a, source_b] >> merge_task
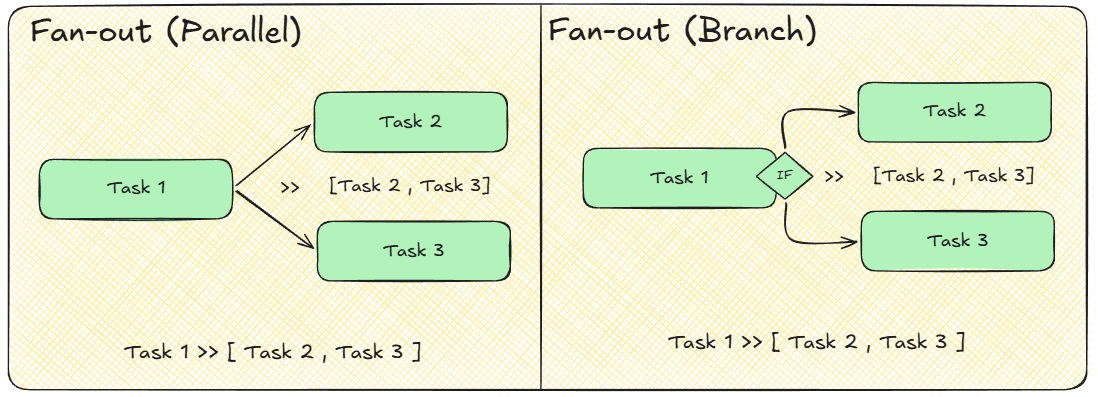
Branch Python Operator - IF
Choose which path to follow at runtime based on a Python function.
Key Parameters
task_id='branch_task': Unique task namepython_callable=choose_branch: Function that returns next task_id(s)op_args=[]: Positional arguments (optional)op_kwargs={}: Keyword arguments (optional)
📌 Use case: Conditional workflow (if/else logic to choose execution path)
# ===================== Import Libraries =====================
from airflow import DAG
from airflow.operators.python import BranchPythonOperator
from airflow.operators.bash import BashOperator
from datetime import datetime

#=======================================================================

# ===================== Branch Decision Function =====================
def check_data_quality(data_is_valid):
    # run some checks on the data
    if data_is_valid:
        return 'run_etl'
    else:
        return 'send_alert'

#=======================================================================

# ===================== DAG Definition =====================
with DAG(
    dag_id='branching_pipeline',
    start_date=datetime(2026, 4, 20),
    schedule_interval=None,
    catchup=False
) as dag:

    # ===================== Branch Decision Task =====================
    branch = BranchPythonOperator(
        task_id='check_quality',
        python_callable=check_data_quality,
        op_kwargs={'data_is_valid': False}
    )

    # ===================== Path A: Good Data =====================
    run_etl = BashOperator(
        task_id='run_etl',
        bash_command='echo "Running ETL..."'
    )

    # ===================== Path B: Bad Data =====================
    send_alert = BashOperator(
        task_id='send_alert',
        bash_command='echo "Data quality issue!"'
    )

    # ===================== Final Task =====================
    final_status = BashOperator(
        task_id='final_status',
        bash_command='echo "Pipeline finished regardless of data quality."',
        # trigger_rule='none_failed'
    )

    # ===================== Task Dependencies =====================
    branch >> [run_etl, send_alert] >> final_status
AirflowSkipException
Skip a task intentionally based on a condition.
Key Parameters
raise AirflowSkipException: Skip task intentionally- Used inside Python callable
- No execution continues for this task
- Downstream depends on
trigger_rule
📌 Use case: Skip tasks dynamically based on condition (if/else logic)
# ===================== Import Libraries =====================
from airflow import DAG
from airflow.exceptions import AirflowSkipException
from airflow.operators.python import PythonOperator
from airflow.operators.bash import BashOperator
from datetime import datetime


# ===================== Python Function =====================
def check_data_availability():
    data_exists = False  # your real check here

    if data_exists:
		print("Data exists. Proceeding with processing...")
	else:
        raise AirflowSkipException("No data today — skipping downstream tasks")


# ===================== Default Arguments =====================
default_args = {
    'owner': 'airflow',
    'start_date': datetime(2026, 4, 20),
    'retries': 1,
}


# ===================== DAG Definition =====================
with DAG(
    dag_id='data_availability_pipeline',
    default_args=default_args,
    schedule_interval=None,
    catchup=False
) as dag:

    # ===================== Check Data Availability Task =====================
    check_data_task = PythonOperator(
        task_id='check_data_availability',
        python_callable=check_data_availability
    )

    # ===================== Process Sales Data Task =====================
    process_sales_data = BashOperator(
        task_id='process_sales_data',
        bash_command='echo "Processing sales data..."'
    )

    # ===================== Process Orders Data Task =====================
    process_orders_data = BashOperator(
        task_id='process_orders_data',
        bash_command='echo "Processing orders data..."'
    )

    # ===================== Task Dependencies =====================
    check_data_task >> [process_sales_data, process_orders_data]
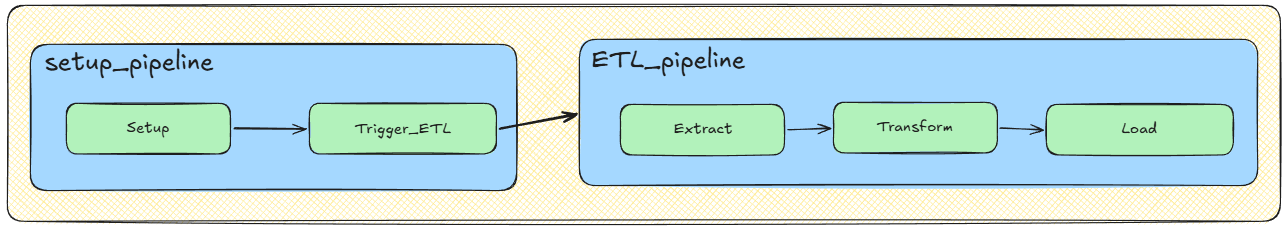
TriggerDagRunOperator
Trigger a different DAG from inside your current DAG.
Key Parameters
task_id='trigger_dag': Unique task nametrigger_dag_id='other_dag': DAG to triggerconf={}: Pass data to triggered DAGwait_for_completion=False: Wait for DAG finish or not
📌 Use case: Trigger another DAG from DAG (pipeline chaining)
# ===================== Import Libraries =====================
from airflow import DAG
from airflow.operators.bash import BashOperator
from airflow.operators.trigger_dagrun import TriggerDagRunOperator
from datetime import datetime

#======================================================================
# ============================ Setup Pipeline DAG =====================
#======================================================================
with DAG(
    dag_id='setup_pipeline',
    start_date=datetime(2026, 4, 20),
    schedule_interval=None,
    catchup=False
) as dag:

    # ===================== Setup Task =====================
    setup = BashOperator(
        task_id='Setup',
        bash_command='echo "Setting up Pipeline..."'
    )

    # ===================== Trigger ETL DAG =====================
    trigger_etl = TriggerDagRunOperator(
        task_id='Trigger_ETL',
        trigger_dag_id='ETL_pipeline'
    )

    # ===================== Task Dependencies =====================
    setup >> trigger_etl

#======================================================================
# ============================== ETL Pipeline DAG =====================
#======================================================================
with DAG(
    dag_id='ETL_pipeline',
    start_date=datetime(2026, 4, 20),
    schedule_interval=None,
    catchup=False
) as dag:

    # ===================== Extract Task =====================
    extract = BashOperator(
        task_id='Extract',
        bash_command='echo "Extracting data..."'
    )

    # ===================== Transform Task =====================
    transform = BashOperator(
        task_id='Transform',
        bash_command='echo "Transforming data..."'
    )

    # ===================== Load Task =====================
    load = BashOperator(
        task_id='Load',
        bash_command='echo "Loading data..."'
    )

    # ===================== Task Dependencies =====================
    extract >> transform >> load
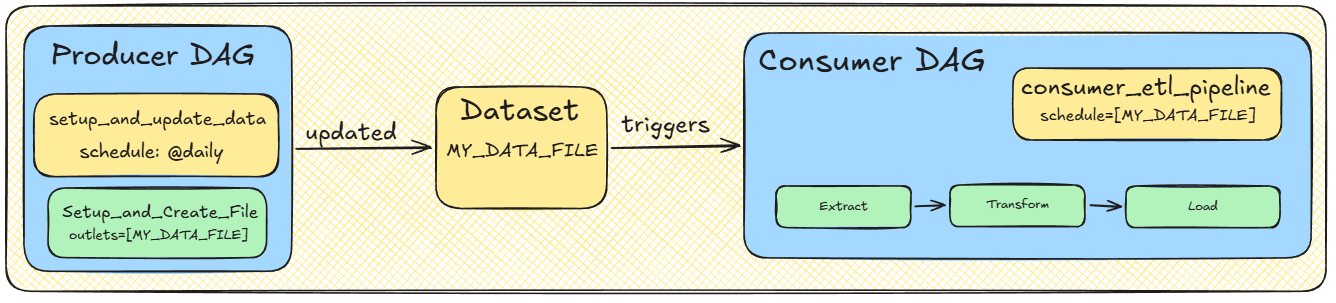
Dataset Scheduling
Trigger a DAG automatically based on data updates instead of time.
Key Concepts
- Dataset A logical representation of a data resource (File, Table, Model).
outlets=[]: ( Producer ) Added to a task to signal that it has updated the data.schedule=[]: ( Consumer ) Added to a DAG to make it wait for a data update to start.
📌 Use case: Data-driven pipelines where DAG (B) runs only when DAG (A) successfully creates a file or updates a table (Event-based orchestration).
# ===================== Import Libraries =====================
from airflow import DAG, Dataset
from airflow.operators.bash import BashOperator
from datetime import datetime

# ===================== Dataset Path =====================
FILE_PATH = "/opt/airflow/dags/data/raw/raw_sales.csv"
MY_DATA_FILE = Dataset(f"file://{FILE_PATH}")

# ========================================================
# ===================== PRODUCER DAG =====================
# ========================================================
with DAG(
    dag_id='producer_setup_pipeline',
    start_date=datetime(2026, 5, 1),
    schedule='@daily',
    catchup=False
) as producer_dag:

    # ===================== Setup & Update Dataset =====================
    setup_and_update = BashOperator(
        task_id='setup_and_update_data',
        bash_command=(
            f'echo "id,product,amount,date\n'
            f'1,Laptop,1200,2026-05-01\n'
            f'2,Mouse,25,2026-05-01" > {FILE_PATH}'
        ),
        outlets=[MY_DATA_FILE]
    )

# ========================================================
# ===================== CONSUMER DAG =====================
# ========================================================
with DAG(
    dag_id='consumer_etl_pipeline',
    start_date=datetime(2026, 5, 1),
    schedule=[MY_DATA_FILE],
    catchup=False
) as consumer_dag:

    # ===================== Extract Data =====================
    extract = BashOperator(
        task_id='extract_data',
        bash_command=f'cat {FILE_PATH}'
    )

    # ===================== Transform Data =====================
    transform = BashOperator(
        task_id='transform_data',
        bash_command='echo "Calculating total sales and cleaning data..."'
    )

    # ===================== Load Data =====================
    load = BashOperator(
        task_id='load_data',
        bash_command='echo "Loading data into destination system..."'
    )

    # ===================== Task Dependencies =====================
    extract >> transform >> load
| Source Type | Dataset URI Example |
|---|---|
| Local File | Dataset("file:///opt/airflow/dags/data/raw/sales.csv") |
| Amazon S3 | Dataset("s3://my-bucket/prefix/data.parquet") |
| PostgreSQL | Dataset("postgres://connection_id/schema/table_name") |
| HDFS | Dataset("hdfs:///user/data/warehouse/fact_sales") |
| Google Cloud Storage | Dataset("gs://my-bucket/logs/app_data.json") |
| Snowflake | Dataset("snowflake://account/db/schema/table") |
Callbacks
Run custom functions automatically on task events.
Key Parameters
on_success_callback=func: Runs when task succeedson_failure_callback=func: Runs when task failson_retry_callback=func: Runs when task retrieson_execute_callback=func: Runs when task starts
📌 Use case: Execute custom actions after task events (success, failure, retry, start)
# ===================== Import Libraries =====================
from airflow import DAG
from airflow.operators.bash import BashOperator
from datetime import datetime
import logging


# ===================== Callbacks =====================

# ===================== DAG Failure Callback =====================
def log_dag_failure(context):
    logging.error(f"DAG {context['dag'].dag_id} failed ❌")


# ===================== Task Success Callback =====================
def log_task_success(context):
    logging.info(f"Task {context['task_instance'].task_id} succeeded ✅")


# ===================== Task Failure Callback =====================
def log_task_failure(context):
    logging.error(f"Task {context['task_instance'].task_id} failed ❌")


# ===================== Default Arguments =====================
default_args = {
    'owner': 'airflow',
    'start_date': datetime(2026, 4, 20),
}


# ===================== DAG Definition =====================
with DAG(
    dag_id="task_callback_pipeline",
    default_args=default_args,
    schedule_interval=None,
    catchup=False,
    on_failure_callback=log_dag_failure
) as dag:

    # ===================== Task: Successful Execution =====================
    print_message_task = BashOperator(
        task_id="print_message",
        bash_command="echo 'Hello Airflow'",

        on_success_callback=log_task_success,
        on_failure_callback=log_task_failure
    )

    # ===================== Task: Intentional Failure =====================
    failing_task = BashOperator(
        task_id="failing_task",
        bash_command="exit 1",

        on_success_callback=log_task_success,
        on_failure_callback=log_task_failure
    )

    # ===================== Task Dependencies =====================
    print_message_task >> failing_task